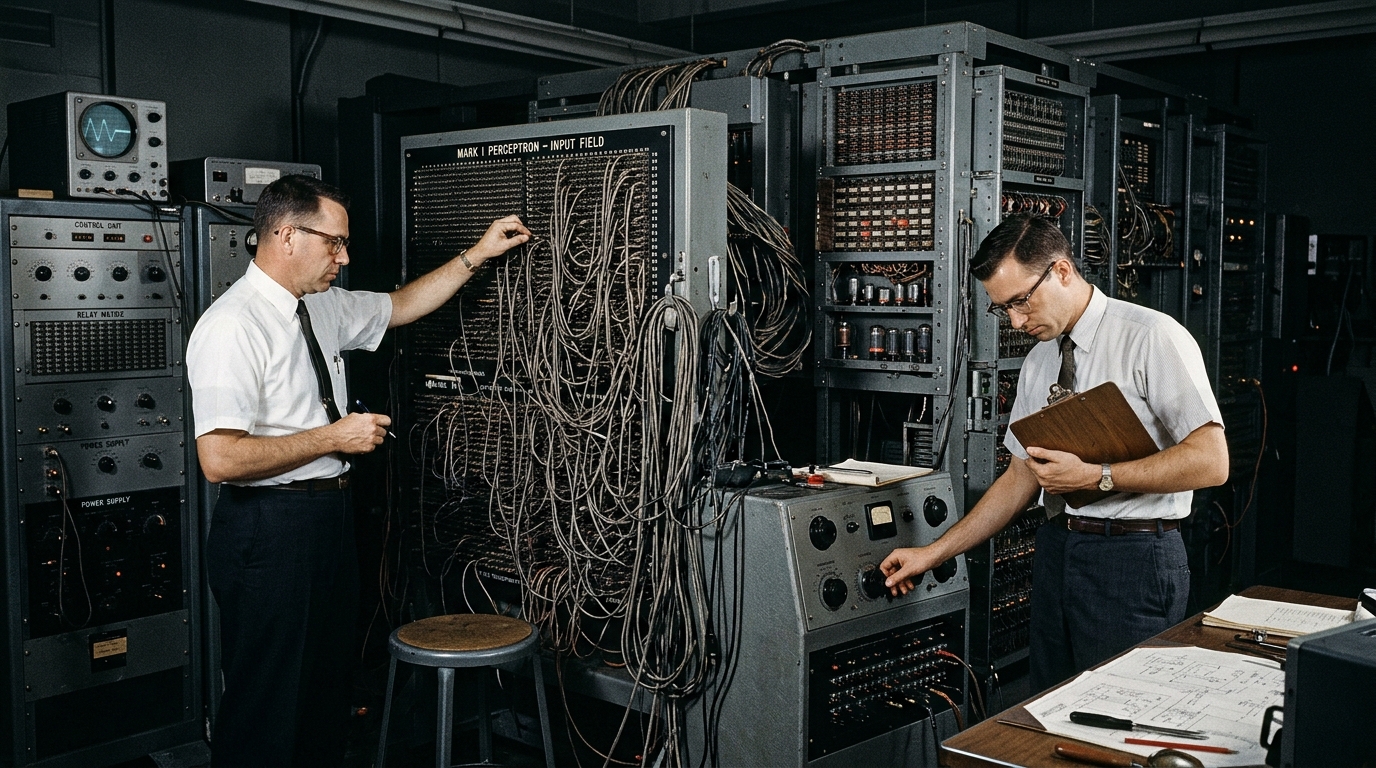
Trong suốt hàng thập kỷ của Mùa đông AI, mạng nơ-ron chỉ là một lý thuyết toán học đẹp đẽ nằm phủ bụi trong các trường đại học. Các thuật toán như Lan truyền ngược (Backpropagation) đã có sẵn từ năm 1986, nhưng tại sao mãi đến những năm 2010 thế giới mới bùng nổ?
Câu trả lời nằm ở một quy luật nghiệt ngã của kỹ thuật: Một thuật toán thiên tài nếu không có phần cứng đủ mạnh và dữ liệu đủ lớn thì cũng chỉ là một đống phế liệu.
Mọi thứ chỉ thực sự thay đổi khi hai dòng chảy công nghệ gặp nhau vào năm 2012: Tập dữ liệu khổng lồ ImageNet và những chiếc chip đồ họa chơi game của tập đoàn Nvidia.
1. Mùa thu năm 2012: Cú nổ AlexNet và thời khắc khai sinh Deep Learning
Để dạy máy tính nhận diện thế giới, việc đầu tiên là phải có dữ liệu mẫu.
Năm 2007, một giáo sư trẻ gốc Hoa tại Đại học Princeton tên là Fei-Fei Li bắt đầu một dự án mà nhiều đồng nghiệp thời đó gọi là “điên rồ và phí thời gian”: Bà tải về hàng triệu bức ảnh từ Internet và thuê hàng chục nghìn người trên nền tảng Amazon Mechanical Turk để dán nhãn thủ công từng bức ảnh (đây là con chó husky, đây là cái tách trà, đây là xe cứu hỏa…). Dự án đồ sộ đó mang tên ImageNet.
Hàng năm, một cuộc thi thị giác máy tính quốc tế được tổ chức trên bộ dữ liệu ImageNet với 1,2 triệu bức ảnh thuộc 1.000 danh mục khác nhau. Trong nhiều năm, các kỹ sư phần mềm hàng đầu thế giới dùng các thuật toán xử lý ảnh truyền thống chỉ đạt tỷ lệ lỗi quanh mức 26% đến 28% và dậm chân tại chỗ.
Đến tháng 9/2012, một sinh viên người Canada gốc Ukraine tên là Alex Krizhevsky, cùng người bạn Ilya Sutskever và người thầy Geoffrey Hinton, gửi đến cuộc thi một mô hình mang tên AlexNet.
Kết quả công bố làm rúng động toàn bộ giới học thuật:
- AlexNet đè bẹp tất cả đối thủ với tỷ lệ lỗi tụt thẳng xuống 15,3% (giảm hơn 10 điểm phần trăm — một khoảng cách chưa từng có trong lịch sử cuộc thi).
- Nhưng cú sốc lớn nhất nằm ở cách họ xây dựng mô hình: Thay vì dùng CPU (bộ vi xử lý trung tâm của máy tính) như mọi người, Alex Krizhevsky mua hai chiếc card màn hình chơi game Nvidia GeForce GTX 580 (giá chỉ vài trăm USD mỗi chiếc thời đó) để huấn luyện một mạng nơ-ron sâu 8 tầng với 60 triệu tham số.
Tại sao chip đồ họa GPU lại tạo ra sự khác biệt sống còn này?
- CPU: Giống như một vài giáo sư toán học lỗi lạc. Nó giải được những bài toán logic tuần tự cực kỳ phức tạp, nhưng mỗi thời điểm chỉ giải được một phép tính.
- GPU: Giống như một đạo quân gồm hàng nghìn học sinh tiểu học. Từng cá nhân không thể giải toán cao cấp, nhưng cả nghìn em có thể đồng thời làm hàng nghìn phép cộng, nhân ma trận đơn giản trong cùng một tích tắc.
Mạng nơ-ron thực chất không có gì huyền bí: Nó chỉ là hàng triệu phép nhân và cộng ma trận số học lặp đi lặp lại. GPU sinh ra để dựng hình đồ họa 3D cho các game thủ bắn súng, tình cờ thay lại chính là kiến trúc phần cứng hoàn hảo nhất cho mạng nơ-ron nhân tạo.
Các ý tưởng về mạng nơ-ron sâu đã có từ trước (Hinton và cộng sự từng có bước tiến quan trọng năm 2006), nhưng AlexNet thường được xem là thời điểm Học sâu (Deep Learning) chính thức bước ra khỏi phòng thí nghiệm và chinh phục cả ngành.
2. Ngõ cụt của mạng tuần tự: Căn bệnh mất trí nhớ của RNN và LSTM
Sau thành công rực rỡ ở lĩnh vực hình ảnh, các nhà khoa học quay sang chinh phục pháo đài phức tạp nhất của trí tuệ con người: Ngôn ngữ tự nhiên.
Ban đầu, họ dùng các mô hình gọi là Mạng nơ-ron hồi quy (Recurrent Neural Networks - RNN) và biến thể cải tiến là LSTM (Long Short-Term Memory), được phát minh từ năm 1997 chính là để giảm bớt chứng “mất trí nhớ” của RNN.
Cách hoạt động của RNN rất giống cách con người đọc sách: Đọc từng từ một theo thứ tự từ trái qua phải:
- Đọc từ thứ 1 → Nén ý nghĩa vào bộ nhớ tạm.
- Đọc từ thứ 2 → Kết hợp ý nghĩa từ 2 với bộ nhớ tạm từ 1.
- Đọc từ thứ 3 → Tiếp tục nén dồn vào…
Cách làm này có hai nhược điểm chí mạng:
- Căn bệnh mất trí nhớ (Bottleneck & Vanishing Gradient): Khi đọc đến những từ ở xa trong một đoạn văn dài, bộ nhớ nén của RNN đã bị pha loãng, khiến nó dễ quên những từ đầu tiên. LSTM cải thiện đáng kể nhưng vẫn gặp khó với văn bản rất dài. Trong ngôn ngữ, một từ ở đầu câu có thể quyết định ý nghĩa của từ ở cuối câu.
- Khó tính toán song song: Vì từ sau phải chờ kết quả của từ trước, GPU hàng nghìn nhân bị buộc phải xử lý tuần tự từng bước, không tận dụng được hết sức mạnh phần cứng.
Dù vậy, giai đoạn 2014–2016 vẫn có nhiều tiến bộ lớn: mô hình chuỗi-sang-chuỗi (seq2seq) cho dịch máy, cơ chế chú ý (attention) đầu tiên do Bahdanau và cộng sự đề xuất năm 2014 để giúp mô hình “nhìn lại” các từ phía trước, và hệ thống dịch máy Google Translate dựa trên LSTM năm 2016. Nhưng giới hạn về độ dài và tốc độ vẫn còn đó. Cho đến mùa hè năm 2017.
3. Năm 2017: Bài báo lịch sử “Attention Is All You Need”
Vào tháng 6/2017, một nhóm 8 nhà nghiên cứu (chủ yếu thuộc Google Brain và Google Research) công bố một bài báo khoa học với tiêu đề khiêu khích: “Attention Is All You Need” (Tất cả những gì bạn cần là sự chú ý).
Trong bài báo này, họ giới thiệu một kiến trúc mạng nơ-ron hoàn toàn mới mang tên: Transformer.
Cốt lõi của bài báo là một tuyên bố táo bạo: Hãy vứt bỏ toàn bộ cơ chế đọc tuần tự của RNN/LSTM, chỉ giữ lại và phát triển cơ chế chú ý. Mô hình nhìn vào toàn bộ câu văn cùng một lúc và dùng một cơ chế toán học gọi là Tự chú ý (Self-Attention).
Giải mã cơ chế Self-Attention cho người non-tech
Hãy xem xét câu sau:
“Con chó không thể nhảy qua cái hàng rào vì nó quá cao.”
Con người chúng ta hiểu ngay chữ “nó” ở đây là đang ám chỉ “cái hàng rào” (vì hàng rào cao thì chó mới không nhảy qua được).
Nhưng nếu đổi một từ duy nhất:
“Con chó không thể nhảy qua cái hàng rào vì nó quá mệt.”
Lúc này, chữ “nó” lập tức được hiểu là đang ám chỉ “con chó” (vì chó mệt nên không nhảy được).
Với các mô hình đọc tuần tự, việc xác định chữ “nó” gắn với danh từ nào là rất khó. Nhưng cơ chế Self-Attention của Transformer giải quyết bài toán này cực kỳ tao nhã:
- Nhìn toàn cảnh: Transformer tiếp nhận toàn bộ các từ trong câu đồng thời.
- Tính điểm kết nối (Attention Score): Với mỗi từ (ví dụ chữ “nó”), thuật toán sẽ so sánh nó với tất cả các từ còn lại trong câu và chấm điểm:
- “nó” liên quan bao nhiêu % tới “con chó”?
- “nó” liên quan bao nhiêu % tới “hàng rào”?
- “nó” liên quan bao nhiêu % tới “nhảy”?
- “nó” liên quan bao nhiêu % tới “quá cao”?
- Tổng hợp ngữ cảnh: Từ “nó” trong mạng nơ-ron không còn là một chuỗi ký tự vô tri. Nó được khoác lên một vector ý nghĩa mới, trong đó mối liên kết giữa “nó” và “hàng rào” được siết chặt bằng một trọng số chú ý khổng lồ.
Toàn bộ quá trình tính điểm này được thực hiện thông qua bộ ba toán học: Truy vấn (Query), Khóa (Key) và Giá trị (Value) — tương tự như cách bạn gõ từ khóa tìm kiếm (Query) trên Youtube, hệ thống đối chiếu với tiêu đề video (Key) để trả về nội dung video chuẩn xác nhất (Value).
4. Tại sao Transformer là bệ phóng cho ChatGPT và Claude?
Sự ra đời của Transformer mang lại hai món quà vô giá cho nhân loại:
- Khả năng nắm bắt ngữ cảnh xa: Trong phạm vi “cửa sổ ngữ cảnh” của mình, Transformer có thể nối mối quan hệ giữa một luận điểm ở trang 1 với một dẫn chứng ở trang 100 của một cuốn sách. Cửa sổ này vẫn có giới hạn, và chi phí tính toán của cơ chế tự chú ý tăng rất nhanh khi văn bản dài ra.
- Khả năng song song hóa khi huấn luyện: Vì không cần đọc tuần tự, khối lượng văn bản khổng lồ có thể được chia ra cho hàng chục nghìn chip GPU tính toán song song.
Tất cả những chữ cái viết tắt đình đám ngày nay đều xuất phát từ Transformer:
- GPT: Viết tắt của Generative Pre-trained Transformer.
- BERT: Viết tắt của Bidirectional Encoder Representations from Transformers.
- Claude, Gemini, LLaMA, DeepSeek: đều dựa trên kiến trúc Transformer, với nhiều cải tiến so với bản gốc năm 2017.
Google phát minh ra Transformer, nhưng trớ trêu thay, chính một phòng thí nghiệm phi lợi nhuận non trẻ tên là OpenAI mới là những người nhìn thấy tiềm năng khủng khiếp nhất của phát minh này khi kết hợp nó với một nguyên lý tưởng chừng rất ngây thơ: Cứ nhồi thêm thật nhiều dữ liệu và máy tính, trí thông minh sẽ tự động xuất hiện.
Trong Bài 4: Bóc Trần Bản Chất LLM — Cỗ Máy Đoán Từ Tiếp Theo Và Định Luật Mở Rộng, chúng ta sẽ lột trần cơ chế thực sự bên trong các mô hình ngôn ngữ lớn: Chúng thực sự làm gì khi trả lời bạn, và ảo giác (Hallucination) sinh ra từ đâu.
Nguồn tham khảo: Deng và cộng sự (2009), “ImageNet: A Large-Scale Hierarchical Image Database”; Krizhevsky, Sutskever & Hinton (2012), “ImageNet Classification with Deep Convolutional Neural Networks”; Hochreiter & Schmidhuber (1997), “Long Short-Term Memory”; Bahdanau, Cho & Bengio (2014), “Neural Machine Translation by Jointly Learning to Align and Translate”; Vaswani và cộng sự (2017), “Attention Is All You Need”.